Betanítsuk a saját modellünket? Megmértük egy olcsó alternatívával szemben
Egy asztali gép, Arany János 485 verse, 64 perc tanulás — és a kérdés, amit minden cég feltesz: megéri-e finomhangolni, vagy elég a jó prompt?
Ez a bekezdés géptől van. Egy nyílt nyelvi modelltől, amit betanítottunk Arany János verseire:
Két árva fiú hányni kezd a sárral,
Hozzájuk egy lyány, az is hány, a bárcsal,
Kétszámra gyűlnek, három, de már négy is:
„Ki a pénzt? ki a zsírt? ki a nyers ebgyísz?”
A forma stimmel: négysoros strófa, tizenegy szótagos sorok, rímelő sorpárok. A hang is ott van, ez egy elbeszélő népi vers lüktetése. Csak épp a „bárcsal”, az „ebgyísz” és a „pénzgyísz” nem létező szavak. A gép találta ki őket, mindet sorvégen, mindet azért, hogy kijöjjön a rím.
Ez a cikk nem versekről szól. Arról szól, hogy mikor éri meg betanítani egy modellt, és mikor elég egy olcsóbb megoldás — és a verselés csak azért jó terep, mert itt vonalzóval mérhető, mi a jó eredmény. A szótagszám a magánhangzók száma. A rím vagy megvan, vagy nincs. Nem kell ízlés, csak egy jól megírt program.
A kérdés, ami minden cégnél előjön
Ha egy modell nem azt csinálja, amit szeretnénk, két kar van a kezünkben:
- Betanítjuk (finomhangolás, LoRA): a saját példáinkkal elhangoljuk a modellt. Ez a divatos válasz. GPU-idő, adatelőkészítés, karbantartás, és minden modellváltásnál újra.
- Megszűrjük a kimenetét: megkérjük a modellt többször, és egy determinisztikus program kiválasztja a legjobb választ. Nincs tanítás, nincs GPU-óra, holnap is működik egy másik modellel.
A csábító mérés az, hogy a betanított modellt a nyers modellhez hasonlítjuk. Ilyenkor a finomhangolás mindig látványosan nyer — és pont az marad ki, hogy ugyanezt tanulás nélkül is megkaphattuk volna.
Ezért kell egy olcsó ellenfél. Nem a nyers modellhez kell hasonlítani, hanem a legjobb megoldáshoz, ami tanulás nélkül elérhető. Ha nincs ilyen a mérésedben, akkor nem azt mérted, hogy megérte-e, csak azt, hogy történt-e valami.
Nálunk ez az olcsó ellenfél így nézett ki: ugyanaz a nyers modell, néhány példával a kérésben, és egy pár tucat soros program, ami nyolc próbálkozásból kiválasztja a legszabályosabbat. Ugyanaz, mint amikor nyolc fotót csinálsz a gyerekről, és egyet raksz ki a falra.
Formában az olcsó megoldás nyert
Minden formai tengelyen: strófaszám, sorhossz, szótagszám, rímarány. És közben harmadannyi kitalált szót gyártott.
| mit mérünk | nyers + példák | + kiválasztás | betanítva |
|---|---|---|---|
| szótagszám pontos | 0,206 | 0,409 | 0,203 |
| strófaméret tartva | 0,802 | 0,938 | 0,735 |
| rímarány | 0,114 | 0,236 | 0,177 |
| kitalált szó (kevesebb a jobb) | 0,019 | 0,013 | 0,044 |
Ez nem meglepő, ha a mechanizmusra nézünk: a kiválasztó program pontosan azt maximalizálja, amit mérünk. A betanítás ezzel szemben csak elmozdítja a modell hajlamait; nincs garancia rá, hogy egy konkrét válasz szabályos lesz.
A formát tehát olcsóbban megveszi egy szótagszámláló és egy rímfüggvény, mint 64 perc GPU-idő. Aki csak szabályos kimenetet akar, annak a finomhangolás rossz vásár.
A fordulat: a hangot viszont nem lehet megvenni
A stílust egy független programmal mértük, ami nem látta a generált szövegeket: felismeri-e Aranynak, amit a gép írt. (Valódi verseken 91%-os pontosságú, a véletlen tippelés szintje 59%.)
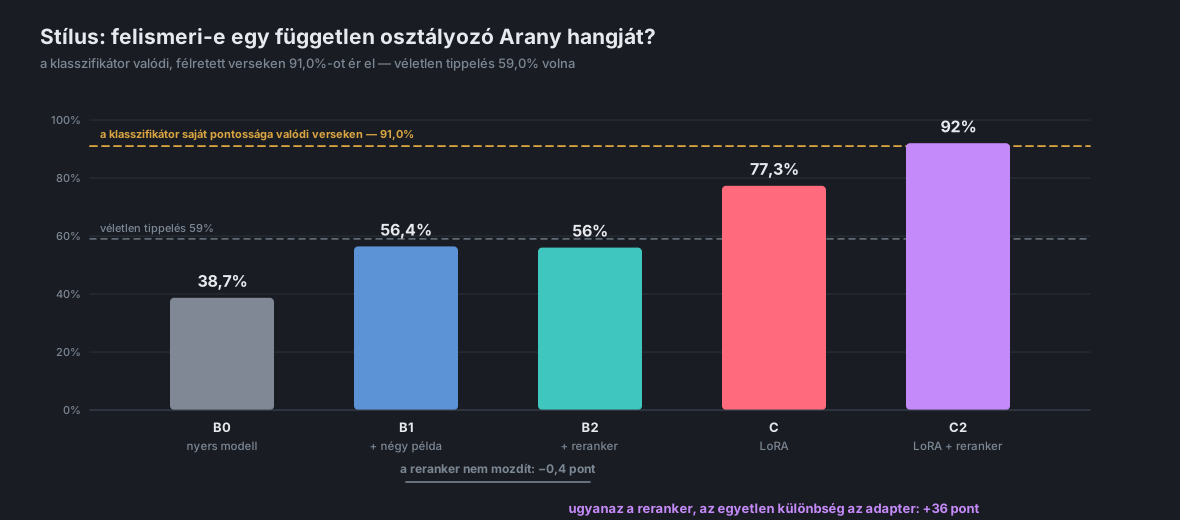
Nézd meg a második és a harmadik oszlopot: a kiválasztó program a stíluson nem mozdít (56,4% → 56,0%). Nem hiba és nem zaj. A programunk szótagot számol és sorvégeket egyeztet; fogalma sincs arról, hogy egy szöveg Aranyra hasonlít-e. Egy szelektor csak azt tudja kiválasztani, amit mérni tud.
A legtisztább összevetés az utolsó két oszlop: ugyanaz a kiválasztó program, ugyanaz az 50 feladat, ugyanaz a nyolc próbálkozás. Az egyetlen különbség a betanítás.
56% → 92%: +36 százalékpont, kizárólag a betanítástól.
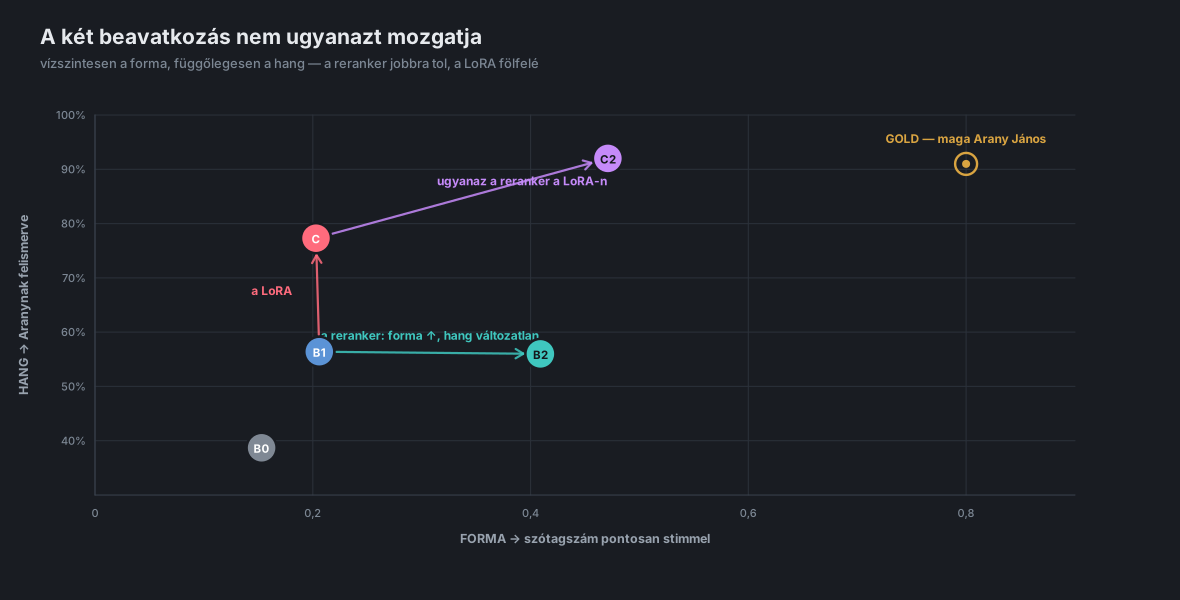
Ez az ábra a cikk egy mondatban. A vízszintes nyíl a kiválasztás: formát javít, hangot nem. A függőleges a betanítás: hangot emel, formát nem. És a kettő nem alternatíva — a legjobb eredmény mindkettőt használja, ráadásul olcsóbban is fut, mert a betanított modellnek nem kell tizenötször hosszabb utasítást olvasnia minden feladat előtt.
Két csapda, amibe majdnem beleestünk
1. A tankönyvi mutató rossz modellt választott. A tanítás során van egy szokásos jelzőszám, ami megmondja, mikor kell abbahagyni. Az a mi esetünkben az egy epochos állapotot javasolta. Lemértük a másikat is, és a „túltanult” változat minden tengelyen jobb volt: rímarány, szótagszám, ismétlés, felismerhetőség. Az ok mechanikus: a jelzőszám azt méri, mennyire jól találja ki a modell a következő szót, mi viszont a modort akartuk. Ha a jelzőszámod nem a feladatot méri, ne az alapján dönts. A helyes döntéshez elég volt egy 50 feladatos mérés, hat percbe került.
2. A metrika a csalást is jutalmazza. A „bárcsal” tökéletesen rímel, tehát a rím-mutató boldog tőle. A betanított modell háromszor annyi nem létező szót gyárt, mint a nyers (0,015 → 0,044). A modell nem a rímelést tanulta meg, hanem azt, hogy a rím fontosabb a szónál. Ezt csak egy második, ellentétes irányú mutató fogta meg — ha egy mérésben minden szám ugyanabba az irányba mutat, valószínűleg nem elég mutatót nézel.
Amitől tartottunk, és nem következett be
A finomhangolás valódi kockázata cégeknél nem a minőség, hanem az, hogy a modell megjegyzi a tanítóanyagot, és később szó szerint visszaadja. Ezt nem lehet utólag „kivenni” a súlyokból, csak újratanítani.
Megmértük: a modell egyetlen generálásban sem adott vissza nyolc szónál hosszabb szó szerinti részletet a tanítóversekből, és a tanított–félretett anyag közti különbség gyakorlatilag nulla — kisebb, mint a nyers modellé. A memorizálás tehát ezen a kísérleten nem következett be.
Két megkötéssel. Ez a mérés erre a korpuszméretre, erre a tanítási beállításra és erre a feladattípusra érvényes; nem általános felmentés. És pont ezért futott az egész közkincs anyagon (Arany és Petőfi művei szabadon felhasználhatók) — védett szövegen a jogi kockázatot nem méréssel, hanem a korpusz megválasztásával kezeljük.
Mit vigyél el ebből, ha modellről döntesz
- Előbb kérdezd meg, mérhető-e a cél. Ha egy szabállyal le tudod írni, mi a jó kimenet (mezőformátum, kötelező mezők, számtani egyezés), akkor egy szűrő olcsóbban és megbízhatóbban megveszi, mint a tanítás.
- Tanítani arra érdemes, amit nem tudsz képletbe írni. Hangnem, szakzsargon, a „nálunk így szokás” — ezt egy szelektor definíció szerint nem tudja kiválasztani.
- Legyen olcsó ellenfél a mérésedben. Nyers modell + jó prompt + egyszerű utószűrő. Enélkül a finomhangolás mindig nyer a papíron.
- A mérőeszközt előbb kell megmérni, mint a modellt. Nálunk ez volt a legunalmasabb két nap, és nélküle minden utána következő szám hihetetlen lett volna.
- A kettő nem alternatíva. A legjobb eredmény mindkét kart használja.
A teljes mérés — 10 fejezet, a korpusztól a mérőeszköz validációján át a hardveres buktatókig, minden számmal és korláttal: Mit ad hozzá egy LoRA a jó promptoláshoz? a Kutatás rovatban.
A mérés végig újrafuttatható: a korpusz közkincs, a modell nyílt súlyú, a mérőeszköz egyetlen külső könyvtárat sem használ. Mind a 800 generált vers, a tanulási görbe, a mérőeszköz validációja és a MEK-csomagok lenyomata nyilvános.